
Trợ lý số cho cán bộ, công chức: xây một nền tảng AI hành chính trong 3 tuần
Trong bài này
Làm việc với nhiều đơn vị hành chính, tôi thấy phần lớn thời gian của cán bộ, công chức không nằm ở chuyên môn mà ở giấy tờ: đọc một tập văn bản dày để tóm ý, soạn công văn sao cho đúng thể thức, ngồi gỡ băng để viết biên bản họp, tìm xem điều nào của luật nào đang áp dụng. Đó là những việc lặp lại, có quy tắc rõ ràng, nên rất hợp để AI hỗ trợ. Trợ lý số CBCC là nền tảng tôi dựng để thử đúng giả thuyết đó. Bài này giới thiệu sản phẩm, kiến trúc ở mức dễ đọc và những bài học rút ra.
Trợ lý số làm được gì
Nền tảng gồm sáu module, mỗi module giải một việc cụ thể:
- Trang chủ: điểm vào, lịch sử làm việc của từng người dùng.
- Tóm tắt văn bản và hỏi đáp: tải lên PDF/ảnh scan, hệ thống OCR, tóm tắt, rồi cho hỏi đáp tiếp trên chính văn bản đó.
- Soạn thảo văn bản hành chính: người dùng chọn loại văn bản, điền vài thông tin chính, hệ thống sinh bản thảo đúng thể thức Nghị định 30/2020/NĐ-CP. Hiện hỗ trợ 15 loại văn bản, từ công văn, quyết định, tờ trình, báo cáo đến kế hoạch, thông báo.
- Biên bản họp từ ghi âm: tải file ghi âm lên, hệ thống tách đoạn, chuyển thành văn bản, rồi trình bày thành biên bản theo mẫu.
- Phân tích dữ liệu: tải bảng số liệu, hỏi bằng ngôn ngữ tự nhiên, nhận lại nhận xét kèm biểu đồ.
- Tra cứu pháp luật: hỏi trên kho văn bản pháp luật đã nạp, câu trả lời luôn kèm trích dẫn nguồn để bấm vào xem lại.
Điểm tôi cố giữ: mỗi module làm một việc, không cố thành “chatbot biết tuốt”.
Kiến trúc: ưu tiên đơn giản để một người vận hành được
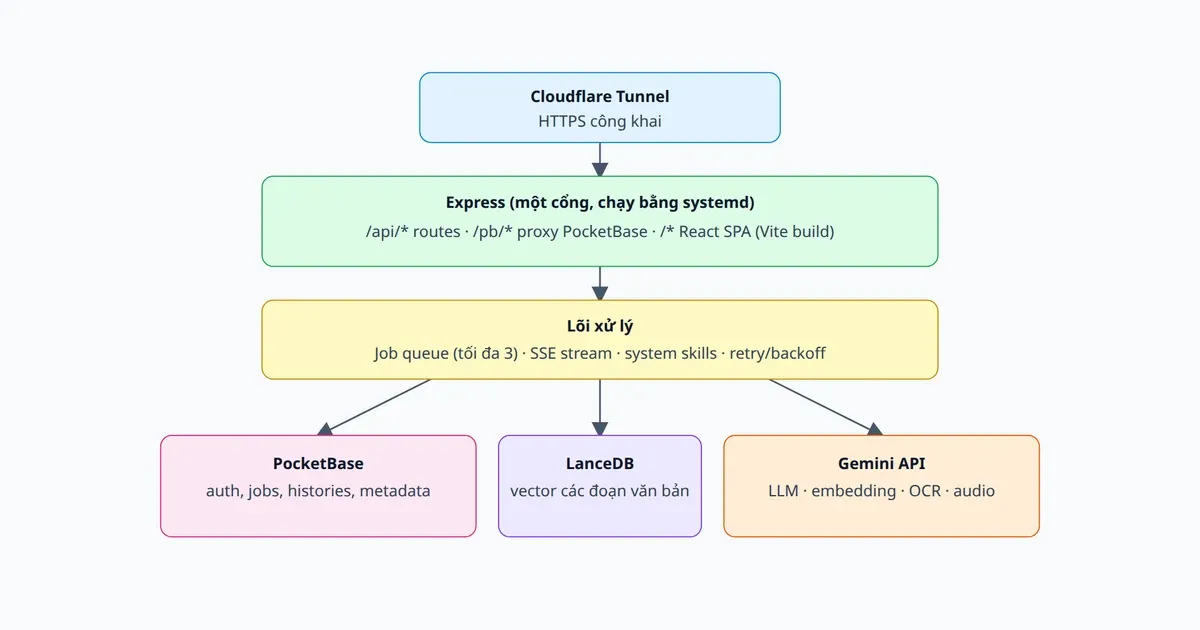
Đơn vị hành chính thường không có đội DevOps, nên tôi chọn stack ít thành phần nhất có thể:
- React 19 + Vite cho giao diện, Express cho backend. Điểm tôi thích nhất là một cổng duy nhất: Express vừa phục vụ API (
/api/*), vừa proxy PocketBase (/pb/*), vừa phát file giao diện (/*). Một cổng nghĩa là một đường hầm, một chứng chỉ, và không còn lỗi CORS khó chịu. - PocketBase (SQLite) lo đăng nhập, người dùng, lịch sử và trạng thái job. Một file binary, không cần dựng Postgres.
- LanceDB lưu vector cho RAG, nằm ngay trong thư mục dự án, không cần dịch vụ riêng.
- Gemini là mô hình ngôn ngữ, embedding, OCR (Vision) và nhận dạng giọng nói.
- Triển khai bằng hai service systemd (PocketBase và backend, cái sau
Requirescái trước), ra Internet qua Cloudflare Tunnel. Không mở port trên máy chủ.
Mỗi người dùng có thể lưu API key Gemini riêng; backend lấy key từ token đăng nhập, không có thì dùng key chung trong .env. Tiện cho thử nghiệm, vì chi phí gắn được với từng người.
Luồng RAG: trả lời kèm nguồn
Khi người dùng hỏi, backend làm theo chuỗi sau:
câu hỏi → embedding (cache LRU 30 phút)
        → tìm vector, lấy 12 đoạn gần nhất (LanceDB)
        → Gemini rerank, giữ 5 đoạn tốt nhất
        → dựng prompt: đoạn văn + hướng dẫn hệ thống
        → Gemini stream câu trả lời → SSE tới trình duyệt
Hai điểm đáng nói. Một là rerank: tìm vector lấy 12 đoạn “gần nghĩa”, nhưng chưa chắc đúng ý; để mô hình chấm lại và giữ 5 đoạn làm câu trả lời bớt lan man hẳn. Hai là stream qua SSE, vì câu trả lời dài mà người dùng không muốn nhìn màn hình trống 20 giây.
Phía nạp văn bản, tôi tính SHA256 của nội dung file làm mã tài liệu. Tải lại đúng file đó thì hệ thống bỏ qua, không OCR và không tính embedding lại. Nghe nhỏ, nhưng với tài liệu pháp luật vài trăm trang và quota API hữu hạn thì tiết kiệm rất thật.
System skills: đóng gói kiến thức nghiệp vụ
Soạn văn bản hành chính không chỉ là “viết hay”. Nó có thể thức cố định (quốc hiệu, tiêu ngữ, số ký hiệu, vị trí chữ ký…) và văn phong riêng cho từng loại. Nếu nhét tất cả vào một prompt khổng lồ thì rất khó bảo trì.
Tôi tách kiến thức này thành các system skills, là những file Markdown nằm trong thư mục skills/system_skills/:
- Một skill về thể thức theo NĐ 30/2020: các thành phần bắt buộc, vị trí, cỡ chữ, cách đánh số.
- Một skill về nội dung và văn phong cho văn bản cấp xã, dựa trên hướng dẫn của Bộ Nội vụ sau khi vận hành chính quyền địa phương hai cấp. Mỗi loại văn bản được mô tả theo cùng sáu chiều: mục đích, trường thông tin bắt buộc, cấu trúc, mẫu câu, lỗi thường gặp và cây quyết định “khi nào dùng loại này”.
Backend nạp skill phù hợp vào prompt theo loại văn bản được chọn. Lợi ích lớn nhất: người có chuyên môn văn thư sửa được kiến thức mà không cần đụng code. Khi quy định thay đổi, ta sửa một file Markdown.
Job chạy nền cho tác vụ dài
Tóm tắt một văn bản scan 80 trang hay chuyển giọng nói một cuộc họp hai tiếng không thể gói trong một request HTTP. Tôi làm một job store nhỏ:
- Trạng thái job lưu trong PocketBase, nên tải lại trang vẫn thấy tiến độ và lịch sử.
- Bộ nhớ trong dùng EventEmitter để đẩy phần trăm tiến độ qua SSE.
- Hàng đợi giới hạn tối đa 3 job song song để không đốt hết quota Gemini.
- Khi backend khởi động lại, các job đang dở của lần chạy trước bị đánh dấu lỗi, để người dùng không nhìn một thanh tiến độ treo mãi.
Chi tiết cuối cùng này dễ bị bỏ qua nhất: thiếu nó, mỗi lần deploy lại là một lần sinh ra job “ma” treo vĩnh viễn trên giao diện.
Dựng trong 3 tuần: cách làm và nợ kỹ thuật
Lịch sử git cho thấy rõ: commit đầu ngày 16/4, đến đầu tháng 5 đã đủ sáu module chạy được. Tôi xuất phát từ một template của Google AI Studio (toàn bộ gọi Gemini từ trình duyệt), rồi nhờ AI coding assistant chuyển dần mọi thứ về backend, thêm RAG, thêm job.
Vibe coding cho tốc độ rất lớn, nhưng nó có giá. Sau tuần đầu, mỗi module có một bản sao riêng của logic gọi Gemini, dựng SSE, xử lý lỗi. Đến ngày 23/4 tôi dành riêng một đợt refactor DRY: gom helper Gemini, prompt, SSE và hook phía frontend vào chỗ chung. Sau đó là tách file soạn thảo quá lớn thành bốn module nhỏ. Kinh nghiệm của tôi: để AI viết nhanh, nhưng phải chủ động dừng lại dọn dẹp định kỳ, nếu không ngữ cảnh AI nhìn thấy sẽ ngày càng rối và chất lượng code nó sinh ra giảm theo.
Bài học và những cái bẫy
Retry với backoff là bắt buộc. API Gemini thỉnh thoảng trả 429 hoặc 503 khi quá tải, hầu hết tự hết sau vài giây. Tôi bọc mọi lời gọi trong một hàm retry thử tối đa 4 lần, chờ 1s, 2s, 4s (trần 8s) và chỉ thử lại với lỗi tạm thời (429, 5xx, lỗi mạng). Trước đó, cứ vài lượt là người dùng thấy lỗi đỏ giữa chừng. Hãy chuyển mã lỗi kỹ thuật thành thông báo tiếng Việt dễ hiểu nữa.
Chống bịa bằng trích dẫn nguồn. Trong lĩnh vực pháp luật, một câu trả lời trôi chảy nhưng sai còn tệ hơn không trả lời. Mọi câu trả lời RAG đều kèm danh sách đoạn nguồn có thể mở ra đối chiếu. Cán bộ không phải “tin AI” mà kiểm tra được trong vài giây. Cũng nên cho phép mô hình nói “không tìm thấy trong tài liệu”.
Nạp dữ liệu phải idempotent. Người dùng sẽ tải lên cùng một file nhiều lần, hệ thống sẽ bị khởi động lại giữa chừng. Dùng SHA256 làm khóa giúp mọi thao tác nạp có thể chạy lại an toàn.
Chọn mô hình theo tác vụ. Tôi cấu hình model riêng cho từng việc (chat, tóm tắt, soạn thảo, biên bản, phân tích, OCR, rerank) qua biến môi trường. Hiện tất cả mặc định về một model Flash-Lite cho rẻ và nhanh, nhưng khi một tác vụ cần chất lượng cao hơn thì tôi nâng đúng chỗ đó mà không sửa code. Tôi đã bỏ phần cho người dùng tự chọn model: cán bộ không cần biết khác biệt giữa các model, và mỗi lựa chọn thừa là một chỗ để hỏi nhầm.
Giảm chiều embedding. Gemini cho phép cắt chiều vector. Tôi đặt mặc định 1536 chiều thay vì chiều đầy đủ của model, vừa nhẹ cho LanceDB vừa đủ chính xác cho văn bản pháp lý.
Soạn thảo cần cơ chế thử lại sáng tạo. Khi model trả JSON hỏng hoặc thiếu trường, hệ thống thử lại với nhiệt độ cao hơn. Một chút ngẫu nhiên đôi khi gỡ được kết quả lặp mà thử lại y nguyên thì không.
Kết
Trợ lý số không thay cán bộ ra quyết định. Nó rút ngắn phần việc cơ học để người có chuyên môn dành thời gian cho phần cần phán đoán. Về kỹ thuật, điều tôi rút ra là: một stack gọn (một cổng, SQLite, vector DB nhúng), kiến thức nghiệp vụ tách thành file đọc được, và nguồn trích dẫn cho mọi câu trả lời, đã đủ để đưa AI vào công việc hành chính một cách đáng tin.